
digital-human-koubo-comfyui
一张照片生成 AI 数字人口播:本地 ComfyUI 全流程(Qwen3-TTS 克隆声音 + MiniMax H3 对口型 + Qwen Image + Music 3),不花积分;5 种剪辑风格 + 48 个博主级包装组件。AI digital-human talking-head videos from o…
Install with your AI
Paste into Claude Code, Cursor, or any agent — it reads the repo and wires the tool into your project.
Install and set up digital-human-koubo-comfyui (release-binary project) into my current project.
Found on https://claudeers.com/digital-human-koubo-comfyui
Repo: https://github.com/walkskysu/digital-human-koubo-comfyui
Homepage/docs: —
Detected install method: release-binary → inspect the README
Category: skills. Platforms: cli, api, desktop.
Read the repo's README for exact setup and env vars, then install it and wire it into my project.

Claudeers Health Verdict:
unknown; community-verified: false. Confirm the source before running anything.
Grab the latest release asset from GitHub.
# download a build from https://github.com/walkskysu/digital-human-koubo-comfyui/releases
git clone https://github.com/walkskysu/digital-human-koubo-comfyui
// compatibility
| Platforms | cli, api, desktop |
|---|---|
| Operating systems | — |
| AI compatibility | claude |
| License | MIT |
| Pricing | open-source |
| Language | TypeScript |
Digital Human Koubo · 本地 ComfyUI 数字人口播
一张照片 + 一句话 → 一条对好口型的数字人口播成片,全程在你自己的显卡上生成。 声音克隆、对口型、场景图、B-roll、配乐、字幕、包装剪辑,你的 AI Agent 通过本地 ComfyUI 自动做完。
简体中文 · English

| 🖥️ 全本地 | 🔑 零积分 · 零 API Key | 💬 一句指令出片 |
|---|---|---|
| 配音、画面、配乐、剪辑都在你的显卡上跑 | 生成不调任何云端接口,花的只是 GPU 时间 | 不写提示词、不连节点、不动剪辑软件 |
基于 Berryxia 的 andyhuo520/digital-human-koubo,本仓库新增全本地 ComfyUI 路线。
一句话,一条成片
你对 Agent 说:
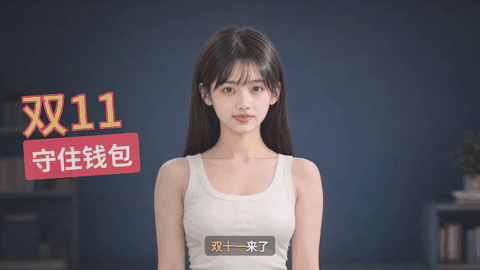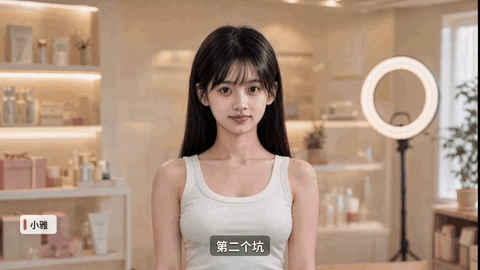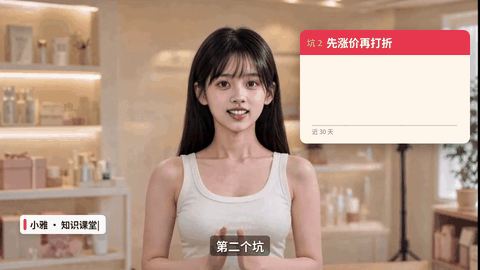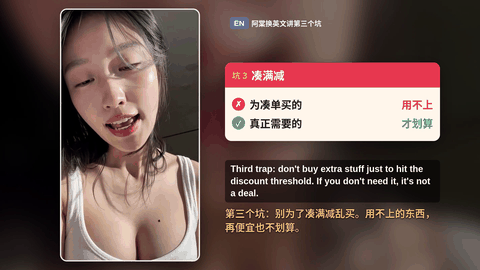
在本地做个口播:9:16 花字,主播用 ella,45 秒,讲一张照片、一台显卡做出五种风格的口播,花字用热闹档。
一张 RTX 3090 跑完后得到这条 44 秒成片(点图看带声音的完整视频):
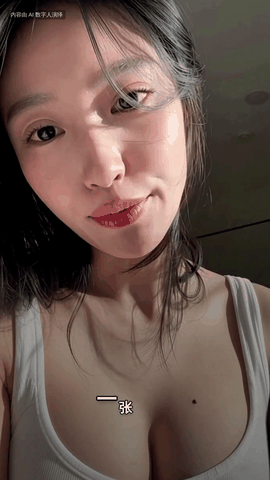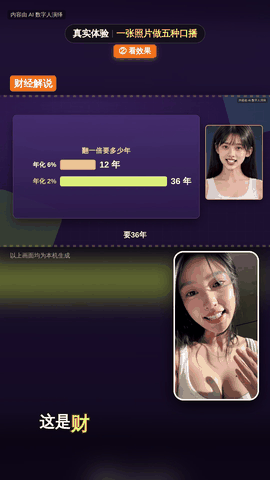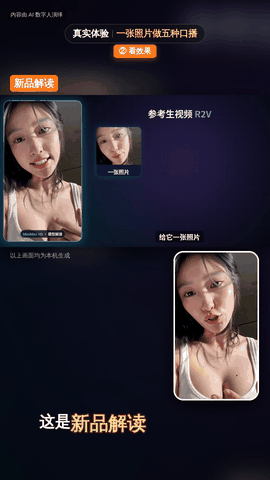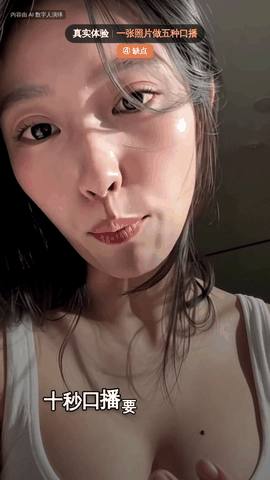
中间你只需要点两次头:确认 GPU 用时估算,看一眼第 1 段。
目录:快速开始 · 适合谁 · 成片示例 · 你不用做的事 · 指令示例 · 流程 · 本地 vs 云端 · 风格与包装 · 文档 · 红线 · 许可
快速开始
前提:一张 24 GB 显存的 NVIDIA 显卡,装好 ComfyUI 0.44 或更新,以及一个能在本机跑命令的 Agent(实测用的是 Claude Code)。
① 下载并把 Skill 装进 Agent
git clone https://github.com/walkskysu/digital-human-koubo-comfyui.git
cd digital-human-koubo-comfyui
mkdir -p ~/.claude/skills && cp -R skills/digital-human-koubo skills/finance-explainer ~/.claude/skills/
② 一条命令检查环境
bash ~/.claude/skills/digital-human-koubo/scripts/doctor.sh
已经装好的打勾跳过,缺什么(ffmpeg、Node.js、whisper、ComfyUI 模型……)它会列出来并给出装法。模型不用手动找:在 ComfyUI 里打开对应的内置模板,缺的模型它会提示下载。完整清单见 安装文档。
③ 打开 ComfyUI,对 Agent 说一句话
在本地做个口播,讲 72 法则,40 秒,9:16。
Skill 检测到 127.0.0.1:8188 在线就走本地路线。仓库自带两个 AI 数字人示例主播和声音样本,不用先准备照片和录音就能出第一条片:
| 主播 | 形象 | 画幅 |
|---|---|---|
annie(默认) | 演播室中景 | 16:9 和 9:16 都有形象图 |
ella | 自拍特写 | 9:16 |
不指定主播就用 annie;想换就在指令里说「主播用 ella」。
用的不是 Claude Code?各 Agent 的装法
本地路线只要 Agent 能装 Agent Skills(标准 SKILL.md 格式)并且能在你电脑上执行命令,不需要 MCP。
| Agent | 装 Skill | 状态 |
|---|---|---|
| Claude Code | ~/.claude/skills/ | ✅ 已实测,示例成片就是用它做的 |
| Codex(CLI / 桌面) | ~/.codex/skills/ | ✅ 预期可用(同一套脚本) |
| OpenClaw | 放进 OpenClaw 的技能目录(见其文档) | ⚙️ 应可用 |
| WorkBuddy | 技能 → 导入文件夹 / 压缩包 | ⚙️ 应可用,菜单名以 App 当前版本为准 |
| 豆包 · 千问办公 · 纳米Work 等 | 产品支持 Agent Skills 就导入 | ⚙️ 需要能在本机执行命令 |
| Claude 桌面端 / claude.ai | 设置里上传技能包 | ⚠️ 只有沙盒,跑不了本地路线;只能做云端路线的写稿和生成 |
适合谁 / 不适合谁
| ✅ 适合 | ❌ 暂时不适合 |
|---|---|
| 有一张 24 GB 显存的 NVIDIA 显卡(实测 RTX 3090 + 34 GB 内存) | 没有独立显卡,或想几分钟内拿到成片 → 用云端路线 |
| 愿意让显卡跑一会儿:40 秒成片约占 40–70 分钟 GPU 时间 | 显存小于 24 GB:没有实测过,不保证能跑 |
| 不想按秒付积分,不想把照片和录音传到生成服务 | 想做几分钟的长片:能做,但 GPU 时间按段数增加(每 10 秒口播约 8 分钟) |
| Windows(ComfyUI Desktop)+ WSL2,或 Linux 原生 | 完全不想碰命令行:安装时需要跑几条命令 |
实测用时(RTX 3090):
| 任务 | 用时 |
|---|---|
| 克隆配音一句(5–14 秒) | 几秒 |
| 主播对口型一段(10 秒) | 约 8 分钟 |
| 场景图一张 | 25–50 秒 |
| B-roll 一段(5 秒) | 5–6 分钟 |
| 配乐一条(35–50 秒) | 1–2 分钟 |
成片示例
五种剪辑风格各一条,全部在一张 RTX 3090 上从头做到成片。每条下面是做这类片子可以说的一句话,点图或「播放」看带声音的完整视频。
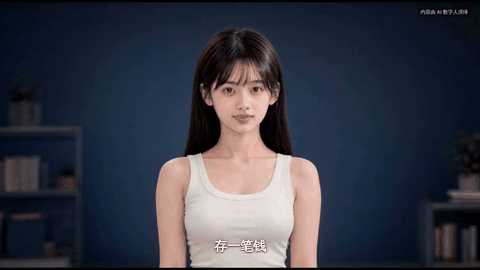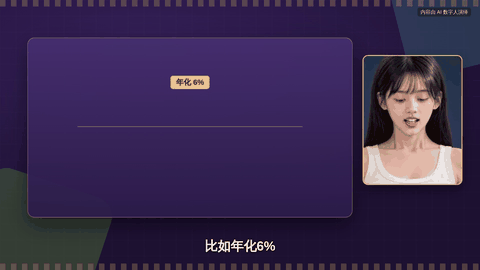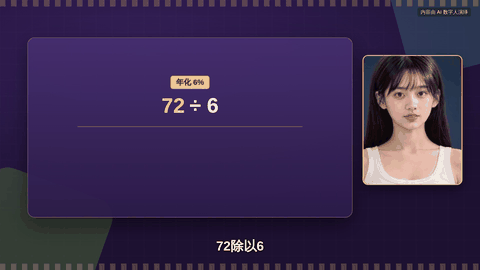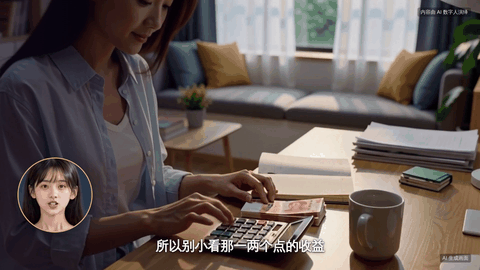 | 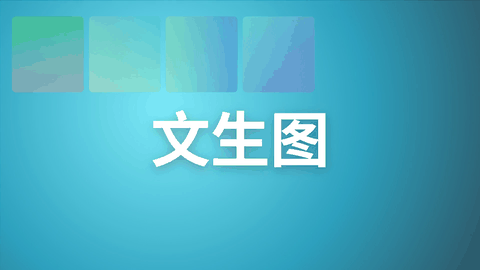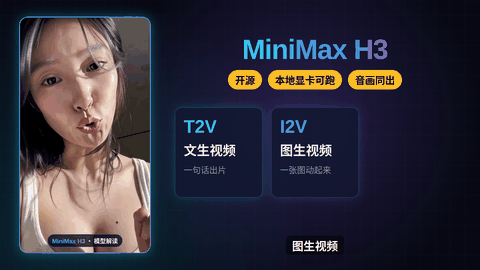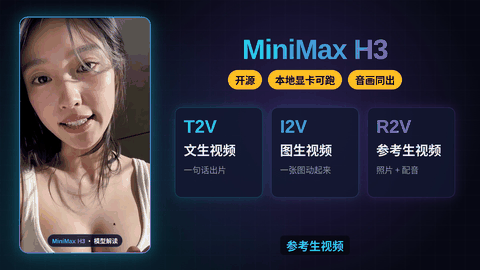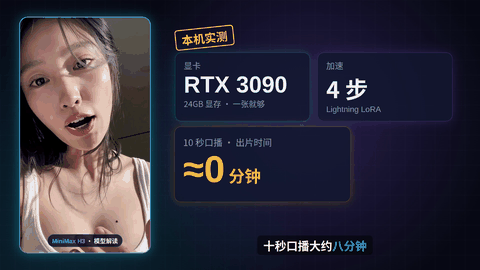 |
| 风格 A · 小林式解说 · 16:9 · 35 秒 · ▶ 播放 「在本地做个口播,小林式解说:72 法则,存一笔钱多久能翻一倍,16:9,35 秒。开场用景深字,算例放题板配主播小窗。」 | 风格 C · 发布解读 · 16:9 · 41 秒 · ▶ 播放 「在本地做个口播,发布解读:MiniMax H3 开源了,画面和声音一起生成,40 秒,主播在侧边,配参数卡。」 |
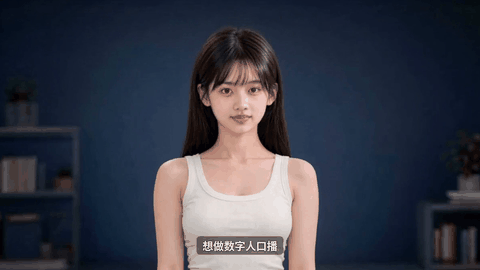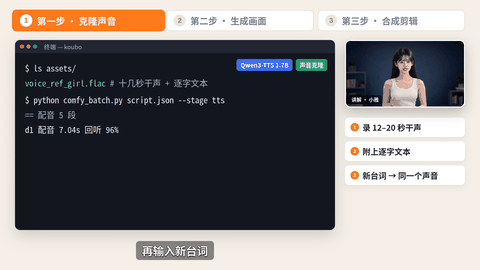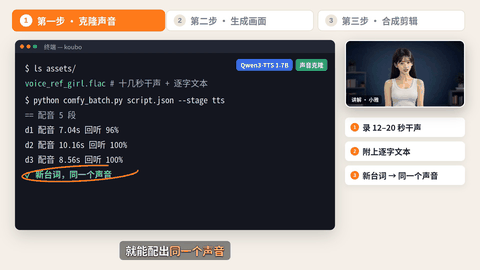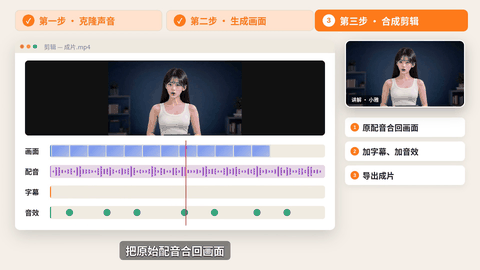 |  |
| 风格 D · 保姆级教程 · 16:9 · 44 秒 · ▶ 播放 「在本地做个口播,保姆级教程:三步在自己电脑上做出数字人口播(克隆声音 → 生成画面 → 合成剪辑),16:9,45 秒。」 | 风格 E · 双主播接力 · 16:9 · 37 秒 · ▶ 播放 「在本地做个口播:annie 和 ella 接力讲双 11 的三个坑,16:9,40 秒。」 |
风格 B(9:16 网红花字口播)就是页面顶部那条。
主播全部是 AI 数字人(
assets/host_annie_*.png和声音样本都是 AI 生成的,不是真人),每条片子都标了「内容由 AI 数字人演绎」。
你不用做的事
| Skill 替你做的 | |
|---|---|
| 生成 | 不用写提示词、不用连 ComfyUI 节点。Agent 写稿、克隆声音、照着配音生成对好口型的主播画面,按需补场景图、B-roll 和配乐。主播的脸、服装、声音存在 persona.json,每条片子都是同一个人。 |
| 把关 | 不会白烧 GPU。开工前先报「段数 · 秒数 · GPU 用时」,你确认才开始;先做第 1 段给你看,满意再批量。中断了可以续跑,只重做改过的段。 |
| 质检 | 不用自己逐句听。每句配音自动回听并和稿子比对,念错了只重配那一句;每段抽帧检查画面;分段生成的声音统一处理成像一次录完的。 |
| 剪辑 | 不用开剪辑软件。按内容推荐剪辑风格,自动上字幕、花字、图表、音效和配乐,统一响度,并把封面接成成片第一帧。想加减什么直接说。 |
也支持多主播接力、英日韩法西阿等多语言、把主播放进生成的场景(直播间、门店、街头)。
指令示例
直接用大白话说,开头一句「在本地做个口播」就行。带「本地」两个字就走本地路线;不说的话,只要 ComfyUI 开着也默认走本地。
# A · 小林式解说(16:9,财经 / 科技事件)
在本地做个口播,讲复利和单利的区别,小林式解说,1 分钟,中间插两段 B-roll。

# B · 网红花字口播(9:16,安利 / 种草 / 吐槽)
本地做 30 秒竖屏种草:这副降噪耳机我用了三个月,说三个优点一个缺点,花字用标准档,结尾引导评论区扣一。

# C · 发布解读(16:9,新品 / 新模型)
本地做一条 45 秒发布解读:Qwen3-TTS 用十几秒录音就能克隆声音,讲三个亮点和一个限制。

# D · 保姆级教程(16:9,几步做出 XX)
本地做一条教程:在 ComfyUI 里装 Lightning LoRA,分四步,每步配终端画面和步骤追踪。

# E · 多主播 · 多语言 · 多场景(16:9)
annie 和 ella 接力讲租房的三个坑:第二个坑把 annie 放进 Qwen Image 生成的小区场景里,第三个坑让 ella 用英文讲。

# 通用
用我的数字人 Skill 讲这段:……(粘贴你的内容)
用 MiniMax Music 生成配乐,用 earshot 重做音效再混音。
讲到这几个国家的时候加地图航线 / 把「¥99」放在她身后 / 开场加个预告闪回。
把包装组件图鉴发我看看
换成你自己的主播:录 12–20 秒干净的声音,加一张正脸照片,在 persona.json → comfy.hosts 里加一项即可(说明)。只用你本人或明确授权的脸和声音。
从一句话到成片
你的一句话
  │
  ├─ Agent 诊断内容、推荐剪辑风格、写稿、估 GPU 用时        ◄ 你确认 ①
  │
  ├─ Qwen3-TTS        克隆主播声音配音 → 自动回听,念错的只重配那一句
  ├─ MiniMax H3       照着这段配音生成主播画面(口型天然对上)  ◄ 先出第 1 段,你确认 ②
  ├─ Qwen Image 2.1   场景图            ┐
  ├─ MiniMax H3       B-roll            ├ 按需
  ├─ MiniMax Music 3  配乐 · earshot 音效 ┘
  │
  ├─ 声音统一 → 逐字时间轴 → Remotion 剪辑包装 → 响度
  └─ 封面接成首帧 → 成片 MP4
本地路线是先配音,再出画面:嘴型是照着最终音频生成的,所以用克隆声音口型也准,事后不用换声音。全部模型都跑在你的 ComfyUI 里,脚本通过它的本地 HTTP API(默认 http://127.0.0.1:8188)提交任务。
每一步跑哪个脚本、哪张工作流、哪些模型文件:见 工作流与架构。想在 ComfyUI 画布里手动跑,把 workflows/ 里的文件拖进去就行。
本地 vs 云端
本仓库在原项目基础上新增的就是本地路线。原来的云端路线(Renoise MCP)仍然保留,每条片子可以自己选。
| 本地 ComfyUI(本仓库新增) | 云端 Renoise MCP(原项目) | |
|---|---|---|
| 花费 | 0 积分,只占 GPU 时间和电费 | 按秒计积分(实测 27 秒直播间广告 482 积分) |
| 账号 / Key | 生成不需要任何账号或 API Key | 需要 Renoise 账号和积分 |
| 素材去向 | 照片、录音、成片都在本机生成,不上传到生成服务 ¹ | 参考图和稿子上传到云端生成 |
| 硬件 | 24 GB 显存的 NVIDIA 显卡 | 不需要显卡 |
| 用时 | 40 秒成片约 40–70 分钟(3090) | 不占本机 GPU |
| 口型 | 照着最终配音生成,克隆声音也对得上 | 跟模型自带的声音;事后换声音约差 100 毫秒 |
| 模型 | Qwen3-TTS · MiniMax H3 · Qwen Image 2.1 · MiniMax Music 3 · BiRefNet | Grok Video 1.5 · GPT Image 2.5 · Wan 3.0 |
¹ 生成在本机完成。如果你的 Agent 用的是云端大模型,稿子和它检查的抽帧仍会经过那个模型。
云端路线的接入、示例和成本:docs/CLOUD.zh-CN.md。
五种剪辑风格
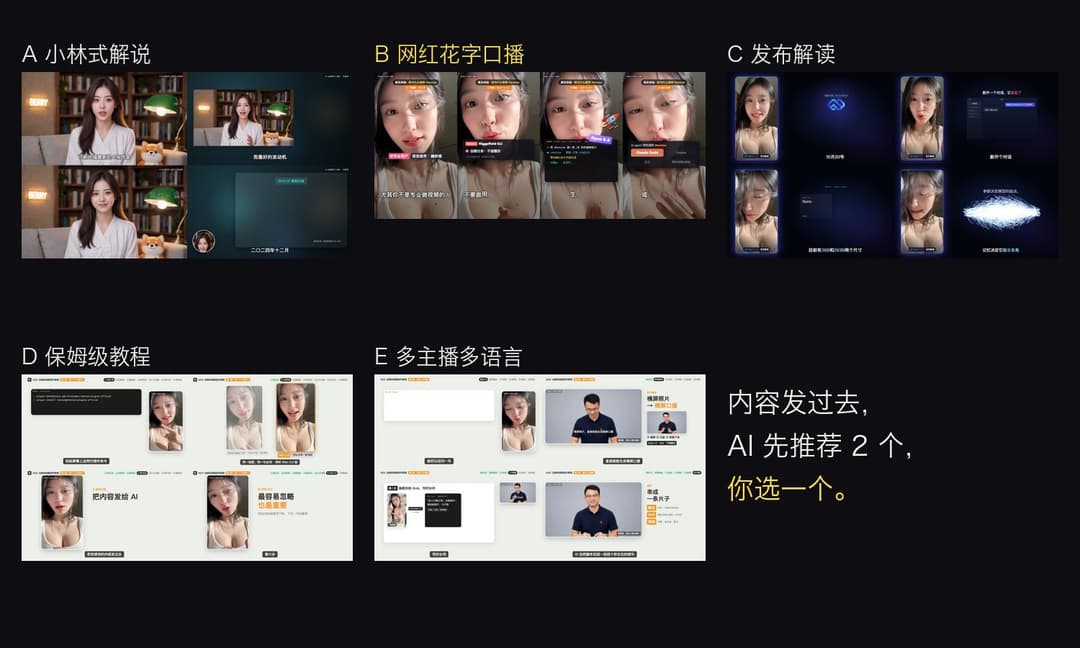
| 风格 | 比例 | 适合 |
|---|---|---|
| A 小林式解说 | 16:9 | 财经 / 科技事件、数据、「为什么」 |
| B 网红花字口播 | 9:16 | 安利、带货、种草、吐槽(花字三档:克制 / 标准 / 热闹) |
| C 发布解读 | 16:9 | 新品、新模型发布 |
| D 保姆级教程 | 16:9 | 几步做出 XX、工具上手 |
| E 多主播 · 多语言 · 多场景 | 16:9 | 能力展示、出海 |
不用自己选:Agent 会先看内容,推荐 2 种并附预览图。本地路线建议先从 30–60 秒做起。
每种风格自带默认包装,来自 48 个包装组件(逐帧拆了 25 支头部博主视频提炼出来的:景深字、数字钉子、对比条、地图航线、弹幕、步骤追踪……)。想加减直接说名字或效果。
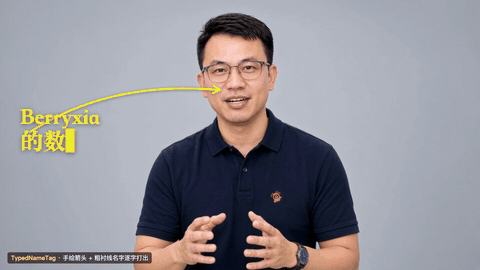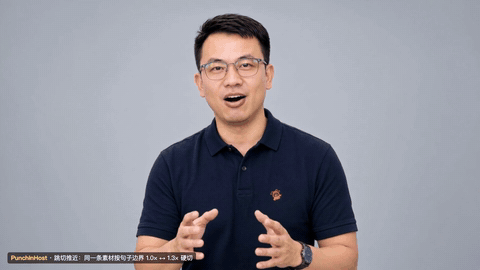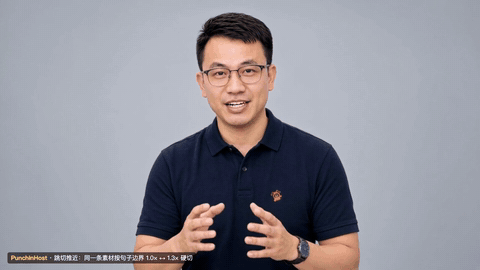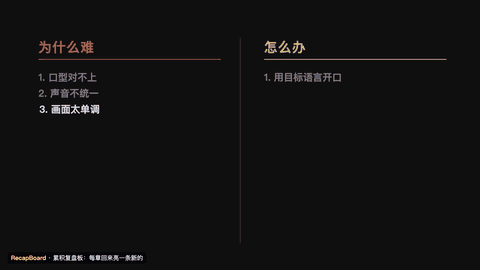
模板、组件清单和参数:docs/PACKAGING.zh-CN.md。
踩过的坑
下面这些 Skill 里都已经处理了,列三条有代表性的:
- 不开 Lightning LoRA,H3 在 24 GB 上会爆显存,卡在第 0 步 → 流程里主播固定用 4 步 LoRA、B-roll 用 8 步。
- Qwen3-TTS 偶尔念糊一个词(比如 MiniMax 念成 mini maxax)→ 每句都不带原文回听比对,念错的换个种子只重配那一句。
- 几十段口播直接拼接,声音会逐段落后口型(实测 44 段后晚 0.38 秒)→ 拼接前把每段音频补齐到画面长度,并校验音画等长。
其余十几条和排查办法:docs/TROUBLESHOOTING.zh-CN.md。
文档
| 文档 | 内容 |
|---|---|
| 安装 | ComfyUI 节点包和模型清单、Python 环境、本机工具、主播声音、earshot |
| 工作流与架构 | 脚本流水线、ComfyUI 工作流和 API 图、模型文件、主播配置、GPU 用时、目录结构 |
| 风格与包装组件 | 五种风格的模板、48 个组件清单、pack 写法、景深字 |
| 云端路线 | Renoise MCP 接入、云端示例、MiMo 语音、积分成本 |
| 踩过的坑 | 本地和云端路线的已知问题与处理 |
workflows/ | 可以直接拖进 ComfyUI 的界面格式工作流 |
使用红线
- 只用你本人或明确授权的脸和声音,不冒充任何真人或创作者。
- 每条片子标「内容由 AI 数字人演绎」,场景和动物片段标「AI 生成」。
- 不编数字、价格、优惠、评价;画面上的示意数据要标「示意」。
- 不用网络梗图、影视剧截图、明星照片;梗图类组件用你自己数字人生成的原创贴纸。
- 积分(云端路线)只在你确认报价之后才花。
许可与第三方
- 代码和文档:MIT © 2026 Berryxia(andyhuo520);本地 ComfyUI 路线 © 2026 walksky。
- 本地路线:ComfyUI(GPL-3.0,自行安装)· 模型 MiniMax H3、MiniMax Music 3、Qwen Image 2.1、Qwen3-TTS、SenseVoice、BiRefNet(自行下载,各有各的许可,商用前请看模型页)· mediapipe(Apache-2.0)· earshot(MIT)及其 CLAP、AST 模型。
- 渲染用的 Remotion 有自己的许可:个人和 3 人以内的公司免费,更大的公司需要购买公司授权。
- 动态表情:Google Noto Emoji Animation(CC BY 4.0),视频里请署名「Animated emoji: Google Noto」。
- 地图:world-atlas(ISC,数据来自 Natural Earth,公有领域)、d3-geo、topojson-client(ISC)。涉及中国边界的正式发布内容,请按国内相关规范另行核对。
- 语音识别:whisper.cpp(MIT)。云端生成走 Renoise(用你自己的账号和积分);可选 TTS 用 小米 MiMo。
- WorkBuddy 示例里的课程截图来自原作者自己的课程。示例视频是各自作者的作品,请不要当成自己的作品二次上传。
详见 THIRD_PARTY.md。
原作者 Berryxia(andyhuo520/digital-human-koubo)· 本地 ComfyUI 路线 walksky · 用 Claude Code 做的 · 有帮助的话点个 ⭐,让更多人看到。
// faq
What is digital-human-koubo-comfyui?
一张照片生成 AI 数字人口播:本地 ComfyUI 全流程(Qwen3-TTS 克隆声音 + MiniMax H3 对口型 + Qwen Image + Music 3),不花积分;5 种剪辑风格 + 48 个博主级包装组件。AI digital-human talking-head videos from one photo, generated locally with ComfyUI (Qwen3-TTS + MiniMax H3 lip sync), no credits. Agent skill for Claude Code / Codex / OpenClaw / WorkBuddy …. It is open-source on GitHub.
Is digital-human-koubo-comfyui free to use?
digital-human-koubo-comfyui is open-source under the MIT license, so it is free to use.
What category does digital-human-koubo-comfyui belong to?
digital-human-koubo-comfyui is listed under skills in the Claudeers registry of Claude-compatible tools.
// embed badge

[](https://claudeers.com/digital-human-koubo-comfyui)
// retro hit counter

[](https://claudeers.com/digital-human-koubo-comfyui)
// reviews
// guestbook
// related in Claude Skills
 🔓
An agentic skills framework & software development methodology that works.
 🔓
 🔓
AI coding assistant skill (Claude Code, Codex, OpenCode, Cursor, Gemini CLI, and more). Turn any folder of code, SQL schemas, R scripts, shell scripts, docs,…
 🔓
💫 Toolkit to help you get started with Spec-Driven Development